oMLX 是一款原生 macOS 推理服务器,基于 Apple 的 MLX 框架,让你可以在 Apple Silicon 上本地运行 AI 模型。无需将数据发送到云端,即可在自己的设备上享受快速、私密的推理体验。
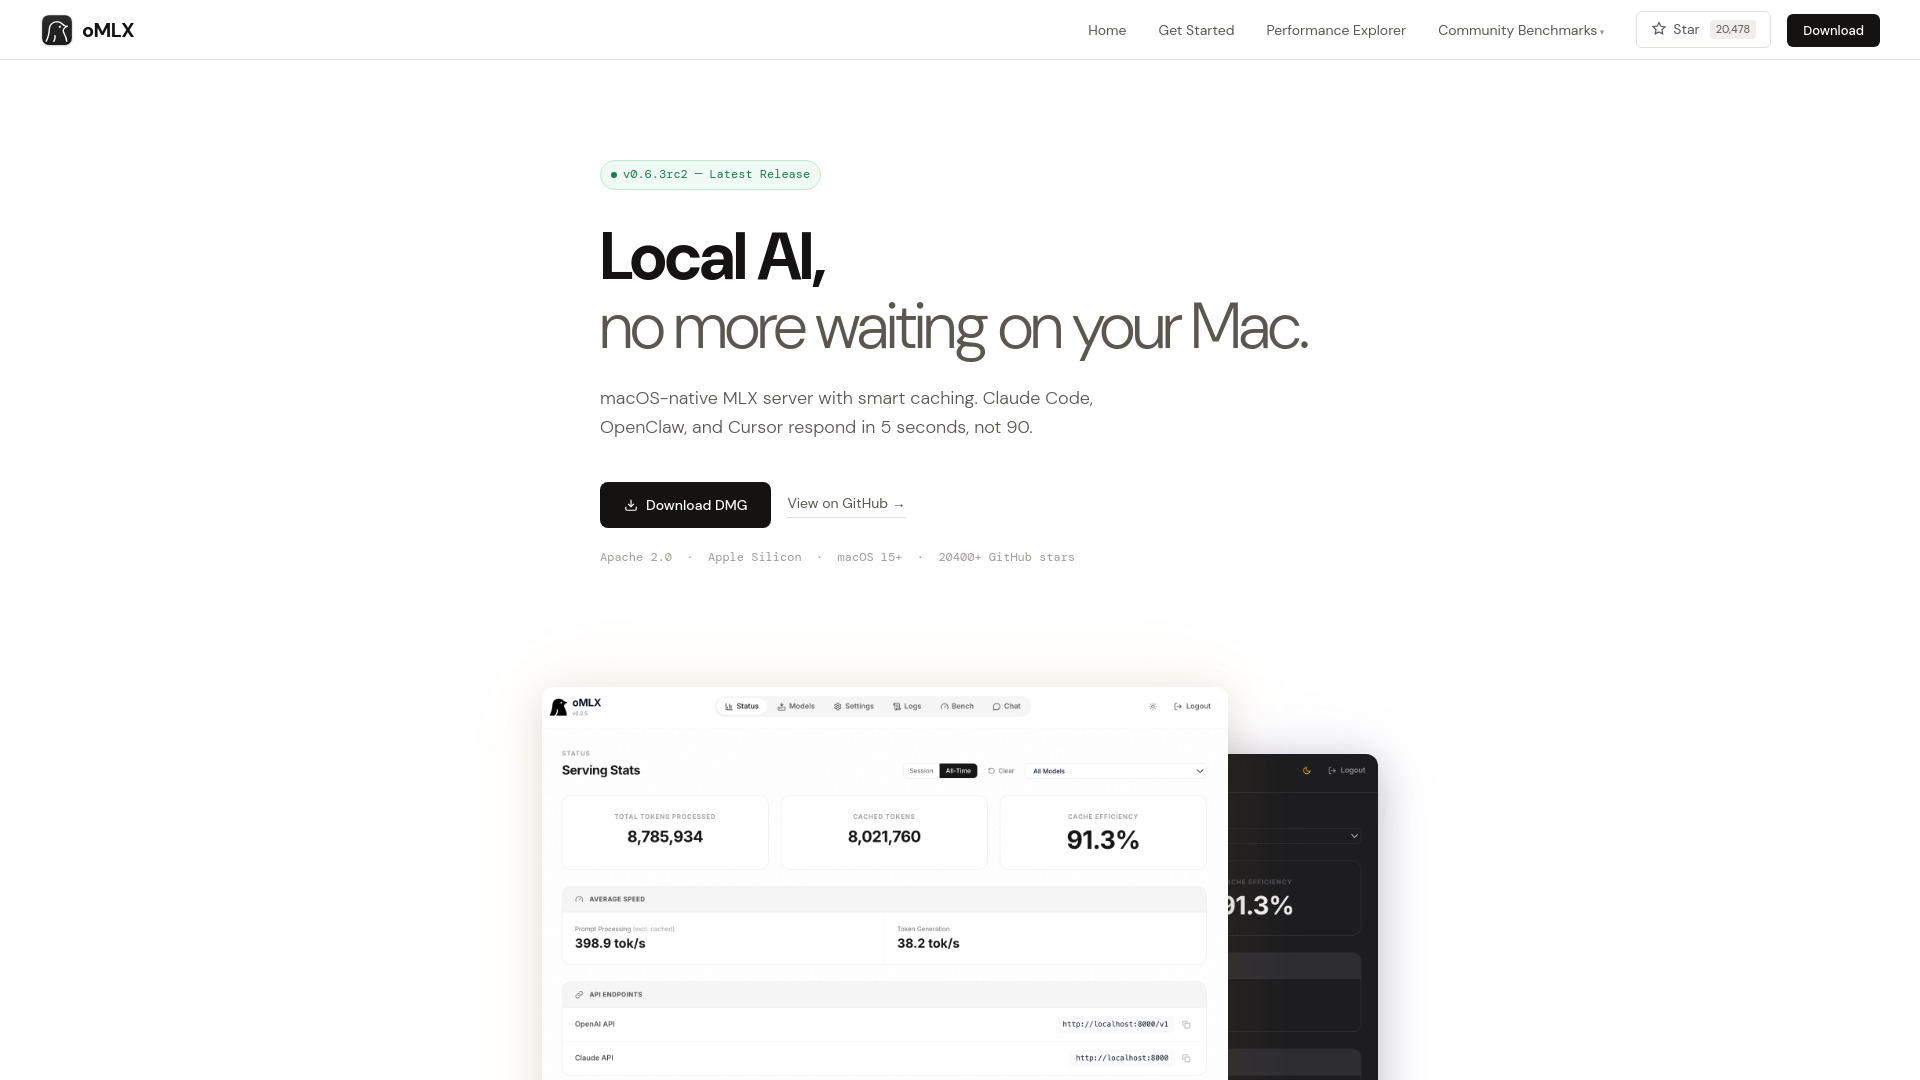
等待首字输出常常拖慢编码智能体的速度,oMLX 提供分页 SSD KV 缓存来缩短首字生成时间,让工作流保持流畅响应。连续批处理技术可在处理多个请求时提升吞吐量,非常适合高负载的本地部署场景。
得益于兼容 OpenAI 和 Anthropic 的 API,接入现有工具十分简单,已有的集成几乎无需改动即可使用。oMLX 支持 LLM、视觉语言、嵌入和重排序模型,并可在同一位置完成工具调用、MCP 集成和多模型服务。
原生菜单栏应用搭配 Web 仪表盘,让你无需离开桌面即可管理模型、监控服务状态,一切尽在掌控。


评论
正在加载评论…