
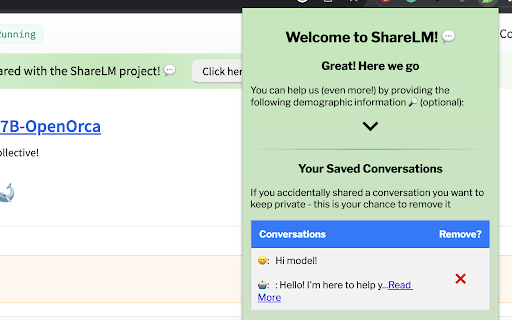
Open Large Language Model Conversation Dataset 是一款浏览器扩展,可自动收集你与开放大语言模型的对话并上传供公开使用。设置完成后,它会在后台静默运行,你只需照常聊天,就能为更大的事业贡献力量。
每一次被收集的对话都会汇入一个持续增长的真实聊天机器人对话数据集。这为开源社区的研究者、开发者和爱好者提供了宝贵的、不断扩充的资源,可用于训练、评估和研究。
分享过程严格遵循规范:每段对话都会在所用特定模型允许的最宽松许可下发布,贡献者可以放心,数据的共享方式完全符合底层模型的条款。


评论
正在加载评论…